Key Takeaway
See the Consequences Before You Ship
A candidate policy can run alongside production on the same traffic, logging what it would have decided without touching a customer. You see the effect on the whole portfolio before you commit, not a quarter later.
Evidence, Not Seniority
Every execution can be recorded as it happens, so there is no warehouse to build and no analyst queue to join. The decisions your rules already made are the data, so policy arguments get answered with what happened rather than with opinion.
Improvement Is a Loop, Not a Project
Changing the logic is an edit, not a release cycle, and whatever you ship can record from its first run. The next question already has its evidence waiting, and the same loop is ready for the one after it.
Jedes Diagramm in diesem Artikel basiert auf einem für die Demo erstellten Beispieldatensatz und nicht auf einem echten Kreditportfolio. Der Mechanismus ist das Produkt. Die Zahlen zeigen die Form der Veränderung.
Die Diskussion ist entschieden
Jeder Kreditgeber kennt dieses Meeting. Growth hält die Genehmigungsschwelle für zu hoch und meint, das Portfolio lehne Geschäft ab, das sicher übernommen werden könnte. Risk verlangt einen Nachweis. Dann geschieht ein Quartal lang nichts, weil der Nachweis einen Datenexport, einen Analysten, einen Neuaufbau des Modells und eine Warteschlange erfordert.
Die Demo auf unserer Decision Intelligence-Seite entscheidet diese Diskussion.
Die Kreditvergabe ist das Beispiel, nicht der eigentliche Punkt. Jede Entscheidung mit einem Schwellenwert folgt diesem Muster: Rabattstufe, Betrugsscore, Regel zur Weiterleitung von Schadenfällen, Berechtigungsprüfung oder Pricing-Band. In Ihrem eigenen Fachgebiet bleibt der Mechanismus identisch.
Die Demo zeigt das in Millisekunden. Im Folgenden wird beschrieben, was darunter ausgeführt wird.
Eine Entscheidung verfolgen
Bevor einzelne Teile betrachtet werden, zeigt dieser Beitrag den vollständigen Weg eines Kredits, der jedes Mal gleich abläuft.
Ein Antrag trifft mit einigen Fakten über einen Kreditnehmer ein. Die Regel liest sie und gibt eine Entscheidung samt Betrag zurück. Diese Entscheidung wird nicht zurückgegeben und vergessen. Im Moment der Entscheidung wird alles protokolliert: Eingabe, Ausgabe, antwortende Version der Richtlinie und Zeitpunkt. Jede Anfrage, jedes Mal.
Diese Aufzeichnung macht aus einzelnen Entscheidungen einen Bestand, aus dem sich lernen lässt. Die Statistics-Seite liest die Datensätze und visualisiert sie. Dadurch wird sichtbar, wie sich Entscheidungen verteilen, wie sich Geldbeträge bewegen und was sich nach einer Richtlinienänderung verändert.
Das ist der Kreislauf und die Grundidee von Decision Intelligence: entscheiden → aufzeichnen → analysieren → verbessern und wieder von vorn. Mehrere Kandidatenrichtlinien können dieselben Anträge parallel bewerten und jeweils protokollieren, was sie entschieden hätten. So lassen sie sich vergleichen, bevor eine davon übernommen wird.
Der restliche Artikel folgt einem vollständigen Durchlauf, beginnend mit der Regel selbst.
Was beim Verschieben eines Reglers ausgeführt wird
Das gesamte Projekt besteht aus fünf Regeln. Das ist die vollständige Logik für die Kreditvergabe: nichts ist in einer Anwendung, einer Stored Procedure oder einer Tabelle auf dem Laptop einer Person verborgen.
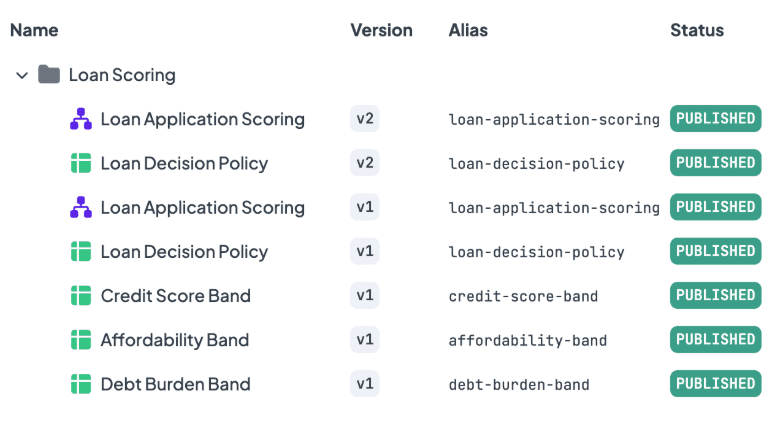
Die vollständige Logik für die Kreditvergabe in einem Ordner. Zwei der fünf Regeln besitzen eine zweite Version.
Zwischen den beiden Punkten führt ein Decision Flow fünf Schritte aus.
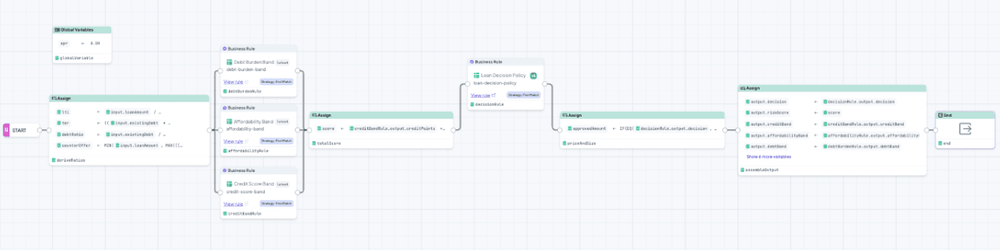
Der vollständige Flow. Drei Bandregeln laufen parallel, speisen einen Score und die Richtlinientabelle entscheidet.
- Verhältnisse ableiten. Ein Kredit über 210.000 € sagt allein nichts aus. Bei einem Einkommen von 120.000 € ergibt sich ein Verhältnis von Kredit zu Einkommen von 1,75. Der Flow berechnet außerdem den höchsten Kredit, der noch innerhalb der Affordability-Obergrenze liegt. Dieser Betrag wird später zum Gegenangebot.
- Drei Dimensionen bewerten. Drei Decision Tables betrachten jeweils einen Aspekt und vergeben Punkte: Kredithistorie, Affordability und bestehende Schuldenlast. Jede Tabelle ist ein kleines Raster, das ein Kreditsachbearbeiter laut vorlesen kann. Die Affordability-Tabelle löst außerdem einen Hard Fail aus, wenn der Antragsteller überschuldet ist. Das ist ein Veto und kein Punktabzug.
- Summieren. Die drei Tabellen erzeugen einen Risikoscore von 0 bis 100. Jeder Antragsteller erhält einen.
- Richtlinie anwenden. Eine vierte Tabelle verwendet den Score und das Hard-Fail-Flag und gibt die Entscheidung zurück. Diese Tabelle ist für den Artikel entscheidend und wird deshalb vollständig gezeigt.
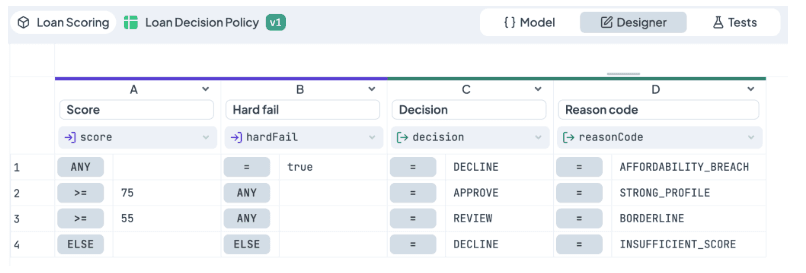
Version 1. Vier Zeilen, zwei Eingabespalten und zwei Ausgabespalten.
Zeile eins ist das Veto: Hard Fail, DECLINE, Grund AFFORDABILITY_BREACH. Zeile zwei genehmigt jeden Score ab 75. Zeile drei leitet 55 bis 74 zur manuellen Prüfung weiter. Zeile vier lehnt den Rest ab. Vier Zeilen, und jede entspricht einem Satz, den ein Fachanwender laut sagen würde.
5. Preis und Umfang des Angebots. APPROVE erhält den beantragten Betrag, DECLINE erhält null und REVIEW wird mit einem vorgeschlagenen Betrag an eine Person weitergeleitet. Dieser Betrag übersteigt niemals die finanzielle Tragfähigkeit des Antragstellers. Die Monatsrate wird mit dem aktuellen APR berechnet, der zentral hinterlegt ist, sodass eine Zinsänderung nur eine Bearbeitung erfordert.
Das ist die vollständige Regel. An anderer Stelle behandeln wir das Design von Credit Scorecards sowie Affordability, Pricing und APR in einem Flow ausführlich. Für diesen Artikel ist alles darüber Kontext. Interessant ist, was geschieht, wenn sich eine der vier Zeilen ändert.
Richtlinie ändern, Nachweise behalten
Zurück zum Meeting. Growth möchte eine niedrigere Schwelle. Deshalb wurde sie gesenkt.
APPROVE wurde von 75 auf 60 verschoben. REVIEW wurde von 55 auf 42 verschoben.
Das ist die gesamte Änderung: zwei Zahlen. Dieselben vier Zeilen, dieselben Spalten, dieselben Reason Codes und dasselbe unveränderte Veto in Zeile eins.
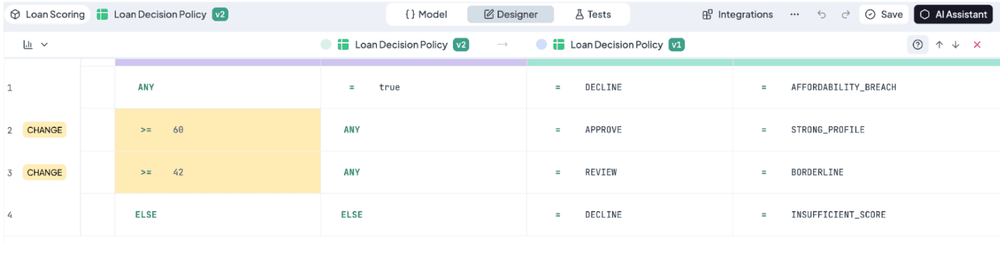
Der Diff. Zwei Zeilen als geändert markiert, zwei Zellen hervorgehoben, alles andere identisch.
Wichtiger als die Bearbeitung selbst ist: Version 1 ist nicht verschwunden.
Vor der Änderung wurde eine neue Version erstellt, sodass die Bearbeitung in Version 2 landete. Die alte Tabelle ist weiterhin vorhanden, lesbar, ausführbar und mit jeder Entscheidung verknüpft, die sie getroffen hat. Fragt eine Aufsichtsbehörde in 18 Monaten, warum ein Antragsteller im vergangenen Mai abgelehnt wurde, stammt die Antwort weder aus dem Gedächtnis noch aus einem Git Blame für eine Konfigurationsdatei. Die genaue Tabelle und das Ausführungsprotokoll existieren weiterhin.
Warum die alte Version weiterläuft
Wenn Version 2 die Verbesserung ist, warum wird Version 1 weiterhin ausgeführt und füllt die Protokolle?
Weil Sie entschieden haben, sie dort zu belassen. production könnte auf „latest version“ zeigen, sodass jede neue Version automatisch übernimmt. Hier geschieht das bewusst nicht. production bleibt an Version 1 gebunden, damit die Änderung kontrolliert bleibt, bis die tatsächliche Wirkung von Version 2 sichtbar ist. Version 2 läuft für dieselben Anträge parallel und protokolliert unauffällig ihre hypothetischen Entscheidungen. Kein Kunde sieht sie und kein Geld bewegt sich ihretwegen. Das ist A/B-Testing im Kreditrisiko, ausgeführt für die Live-Population, ohne sie der Änderung auszusetzen.
Anschließend werden beide Protokolle verglichen. Bewährt sich Version 2, erfolgt die Umstellung und Version 1 stoppt. Andernfalls wurde das Problem zum Preis von etwas Speicherplatz erkannt und nicht erst nach einem Quartal schlechter Kredite.
Bewusst nur ein Unterschied
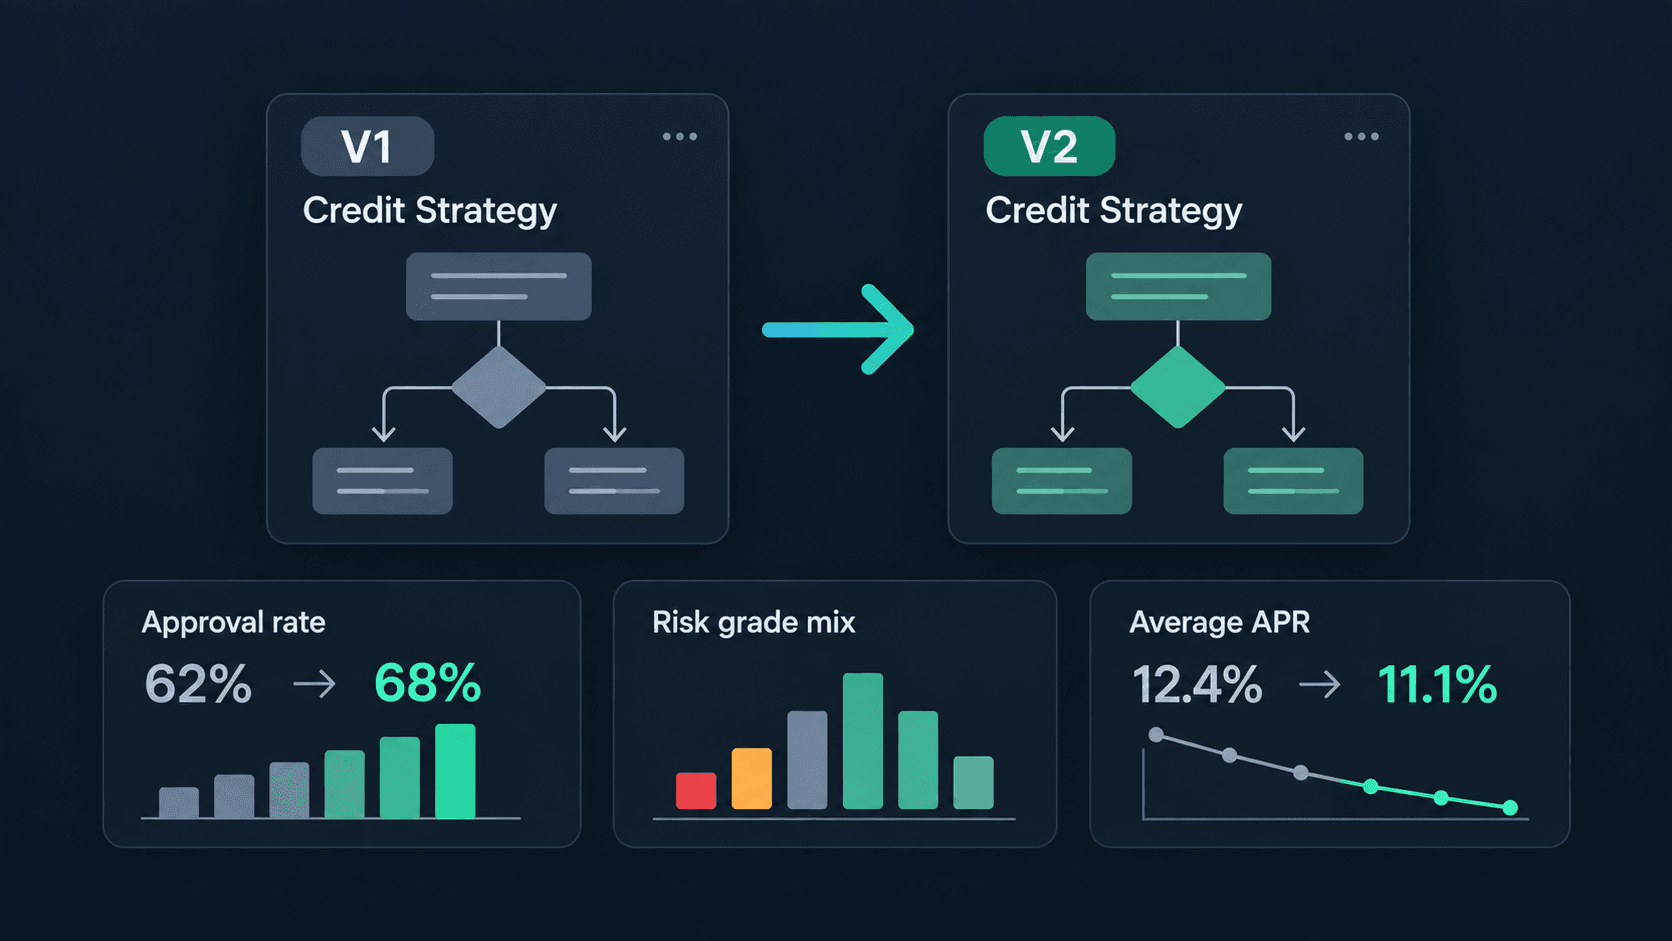
Auch vom Flow existieren Version 1 und Version 2. Nebeneinander betrachtet gibt es genau einen Unterschied: Der Node für die Richtlinie ist einmal an policy v1 und einmal an policy v2 gebunden.
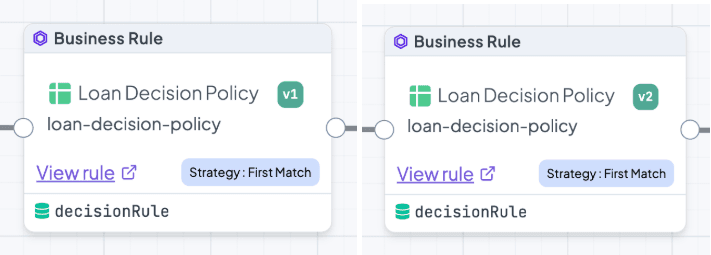
Eine Variable. Derselbe Alias, dieselbe Strategie, derselbe Ausgabename, eine andere fest gebundene Version.
Alles andere wird gemeinsam verwendet. Dieselben Verhältnisse, dieselben drei Scoring-Tabellen…
Das ist beabsichtigt und unterscheidet eine Demo von einem Experiment. Wenn dieselben Anträge beide Flows durchlaufen und die Diagramme auseinanderlaufen, gibt es genau eine mögliche Erklärung, weil es genau einen Unterschied gibt. Niemand kann behaupten, die Kreditbänder hätten sich verschoben oder das Pricing sei heimlich geändert worden.
Was Statistics gezeigt hat
Alles Folgende stammt aus einer einzigen Quelle: den Protokollen.
Jede Ausführung hinterlässt einen Datensatz
Wenn eine Regel mit aktivierter Protokollierung ausgeführt wird, speichert DecisionRules alles: die vollständige Eingabe, die vollständige Ausgabe, die antwortende Version und den Zeitpunkt. Kein Zähler und keine Stichprobe, sondern der Datensatz.
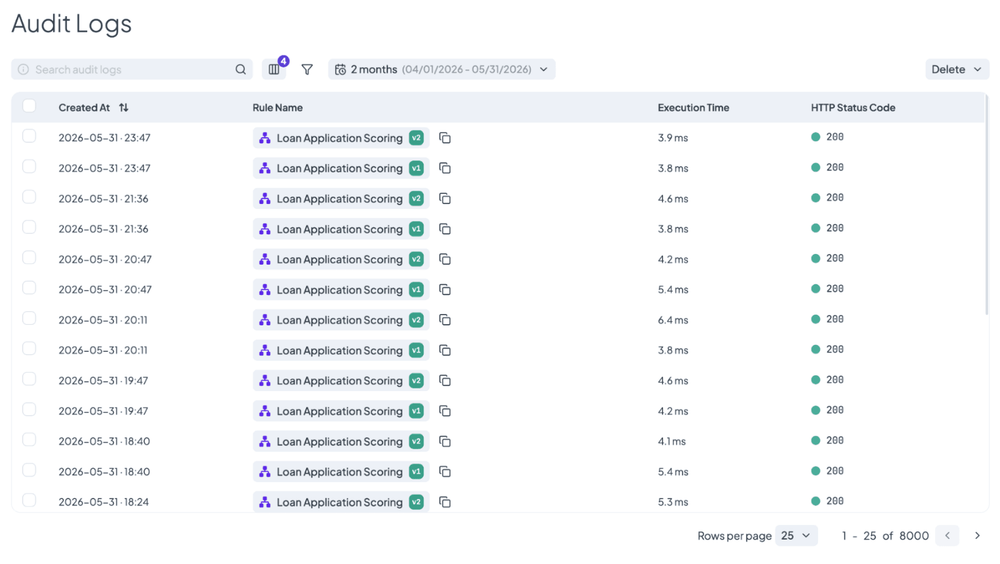
Jeder Antrag wurde zum selben Zeitpunkt zweimal protokolliert, einmal pro Version.
Das ist das Rohmaterial. Statistics benötigt weder ein Warehouse noch einen ETL-Job oder ein Ticket an ein Analytics-Team. Es liest die bereits vorhandenen Protokolle.
Drei Entscheidungen
Die Analyse einer Regel läuft auf drei Fragen hinaus: welche Regel, welcher Zeitraum und welches Feld.
Die ersten beiden werden ausgewählt. Das dritte ist das Data Dictionary. Es wird von niemandem deklariert oder gepflegt, sondern aus den Protokollen aufgebaut. Dadurch enthält es die Felder, die tatsächlich in realen Ausführungen vorkamen, geordnet in drei Bereiche:
- Inputs: die mit jedem Aufruf eingegangenen Daten
- Outputs: die von der Regel zurückgegebenen Daten
- Metadata: technische Fakten der Ausführung wie Version, Status, Zeitstempel und Ausführungszeit…
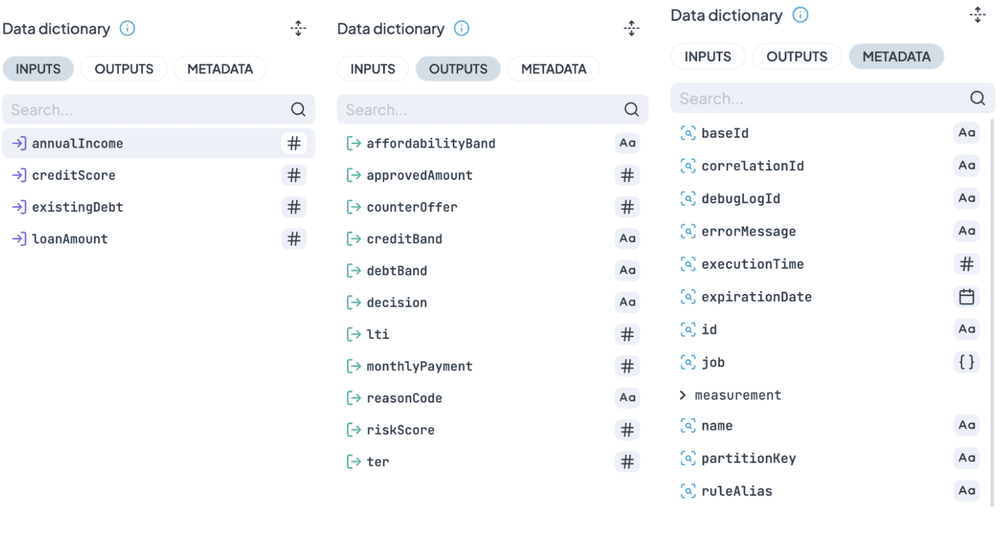
Niemand hat diese Liste geschrieben. Sie wird aus den tatsächlichen Rückgaben der Regel aufgebaut.
Die praktische Folge: Das Dictionary beschreibt, was Ihre Regel tatsächlich getan hat, nicht was sie laut Schema tun sollte. Wenn ein Feld seit drei Wochen unbemerkt nicht mehr erzeugt wird, fehlt es in der Liste. Bereits diese Abwesenheit ist eine relevante Information.
Für diese Regel enthalten Outputs elf Felder, die der Flow zusammenstellt. Die Demo-Seite zeigt zwei davon, decision und approvedAmount, weil über diese beiden im Fachbereich diskutiert wird. Die übrigen neun befinden sich in denselben Protokollen und sind mit einem Klick erreichbar. So lässt sich auch die Anschlussfrage beantworten.
Vergleiche funktionieren auf zwei Arten
Nach Aktivierung des Vergleichs und Auswahl einer zweiten Regel wird jedes Diagramm zweimal gezeichnet. Zwei Situationen beantworten unterschiedliche Fragen.
Beide Versionen, dieselben Tage. Das ist der oben beschriebene Parallelbetrieb. Version 1 bedient production, Version 2 protokolliert parallel und beide verarbeiten im selben Zeitraum dieselben Anträge. Die Frage lautet, ob die neue Richtlinie für dieselben Personen anders entschieden hätte. Da die Population identisch ist, stammt jede Abweichung ausschließlich aus der Richtlinie.
Alte Version vorher, neue Version nachher. Nach der Umstellung stoppt Version 1 und Version 2 übernimmt. Beide erscheinen deshalb nie am selben Tag. Der Vergleich erfolgt über Zeiträume. Im Diagramm zeigt die primäre Seite April, als Version 1 allein 1.992 Entscheidungen protokollierte. Die Vergleichsseite zeigt Mai, als Version 2 übernommen und 2.008 Entscheidungen protokolliert hatte. Zwei Zeitfenster, zwei Versionen, ein Diagramm und keinerlei Überlappung.
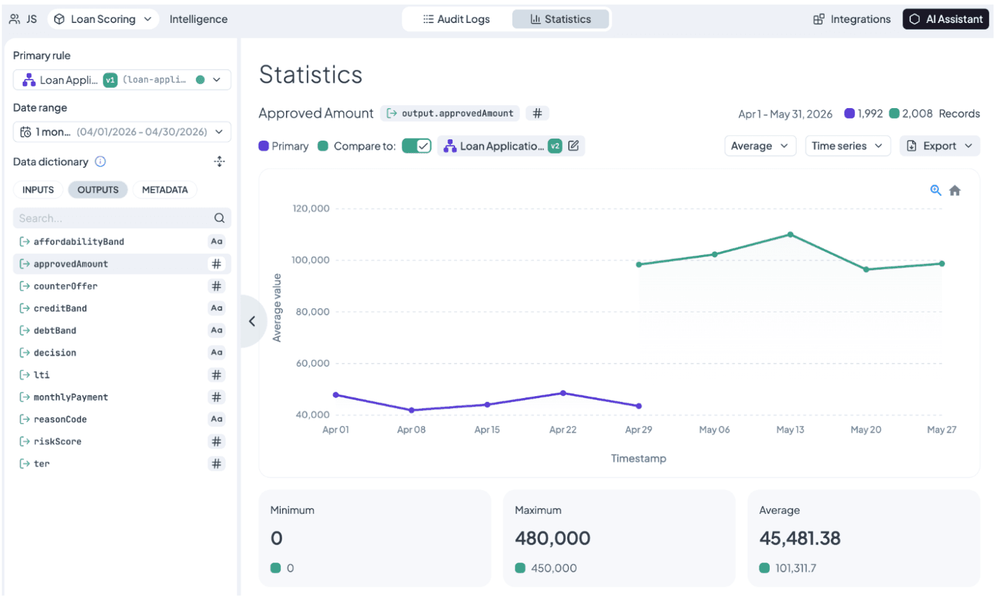
Zwei Zeitfenster, zwei Versionen, ein Diagramm. Die Linien teilen keinen Tag.
Das funktioniert, weil jede Vergleichsseite einen eigenen Datumsbereich hat. Die beantwortete Frage unterscheidet sich vom Parallelbetrieb: nicht, ob die neue Richtlinie anders entscheiden würde, sondern ob sie nach dem Go-live so arbeitet, wie es der Test erwarten ließ. Diesen Vergleich führen die meisten Teams tatsächlich durch, weil er zeigt, ob sich das Versprechen in production bewährt.
Der Zeitpunkt der Einführung ist sichtbar
So sieht ein Parallelbetrieb aus, wenn das Zeitfenster weit genug geöffnet wird, um seinen Beginn zu erfassen.
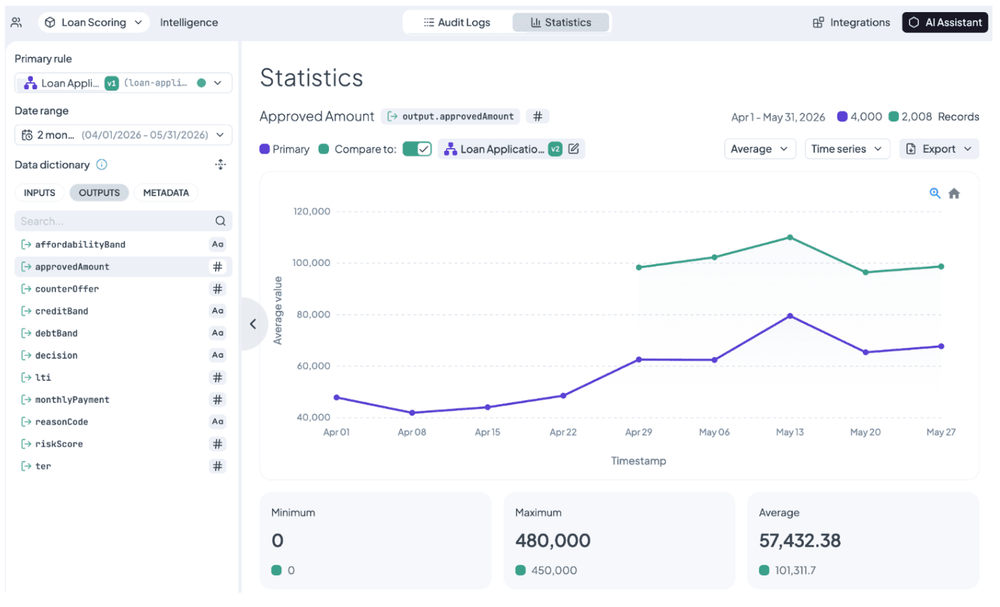
Niemand hat dies annotiert. Die grüne Linie beginnt dort, wo die zweite Version beginnt.
Version 1 lief seit Anfang April. Ende des Monats wurde Version 2 parallel eingeführt, und ab diesem Tag protokollierten beide.
Niemand hat das Diagramm annotiert. Es gibt keinen Bereitstellungsmarker, keine an der Achse befestigte Release Note und keinen Analysten, der nachträglich Kontext ergänzt. Die grüne Linie beginnt dort, wo Version 2 beginnt, weil die Protokolle den Startzeitpunkt kennen und das Diagramm ihre Daten zeichnet. Die Lücke zwischen den Linien öffnet sich sofort und schließt sich nicht mehr.
Das ist der Nutzen von „jede Entscheidung auditieren“. Die Geschichte Ihrer Logik ist kein Dokument, dessen Aktualisierung jemand im Gedächtnis behalten muss. Sie befindet sich in den Daten.
Die Verteilung der Entscheidungen und warum der Grund wichtiger ist
Nun wird das Zeitfenster auf Mai begrenzt, damit beide Versionen exakt dieselben Tage und Anträge abdecken.
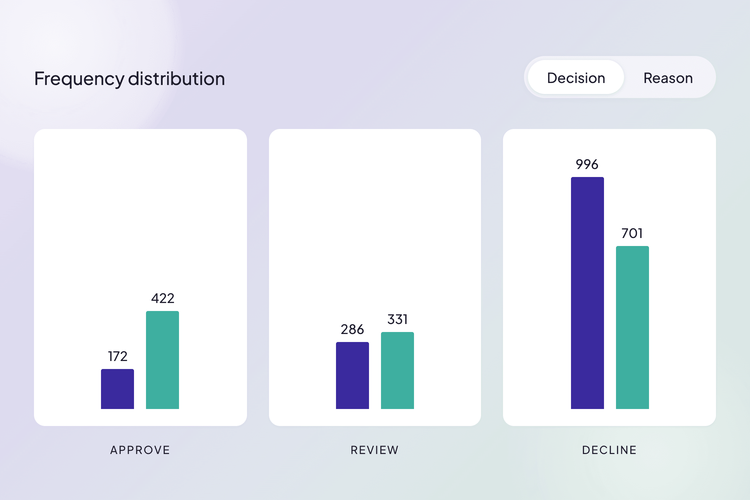
decision ist ein Textfeld, deshalb zählt Statistics seine Werte. Drei Werte, drei Balken, zweimal gezeichnet.
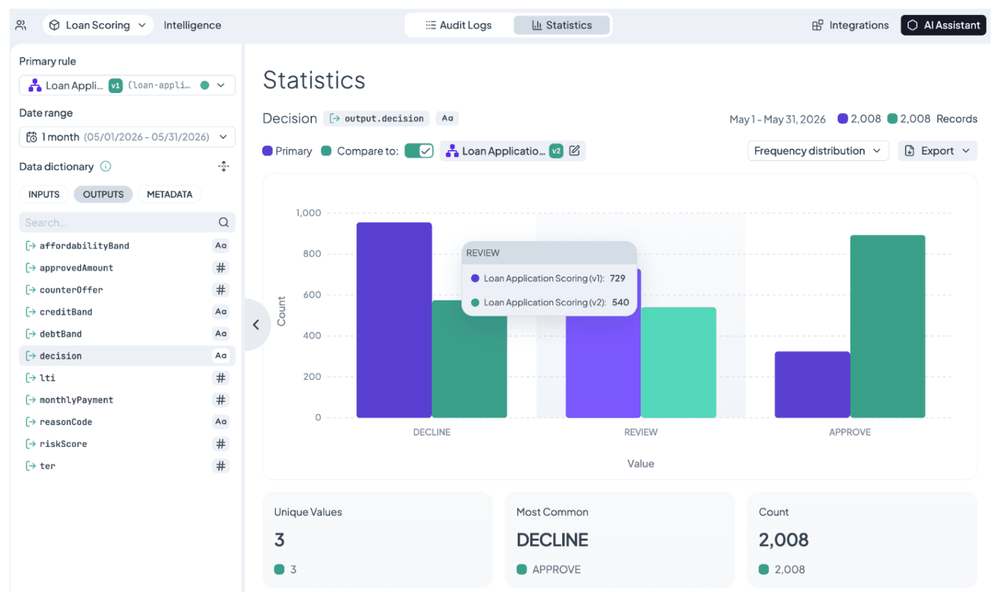
Dieselben Anträge, dieselben Scores. Nur die Grenzlinien wurden verschoben.
- DECLINE [955] → [575]
- REVIEW [729] → [540]
- APPROVE [324] → [893]
Dieselben Anträge und dieselben Scores, weil sich nichts an der Score-Erzeugung geändert hat. Nur die Grenzlinien wurden verschoben, und das Portfolio ordnete sich um die neuen Linien neu.
Die REVIEW-Spalte überrascht. Die Senkung der APPROVE-Schwelle von 75 auf 60 wandelte nicht nur Ablehnungen in Genehmigungen um. Ein Teil der bisherigen Review-Warteschlange wechselte in die direkte Genehmigung. Dadurch sinken die Kosten der manuellen Kreditprüfung, statt lediglich mehr Volumen ins Portfolio zu gelangen. Ein Modell-Backtest, der nur gute und schlechte Kredite betrachtet, würde diesen Vorteil nicht zeigen.
Nun wird dasselbe Diagramm auf reasonCode umgestellt. Dieses Diagramm ist wichtiger. Der Grund dafür sollte klar sein.
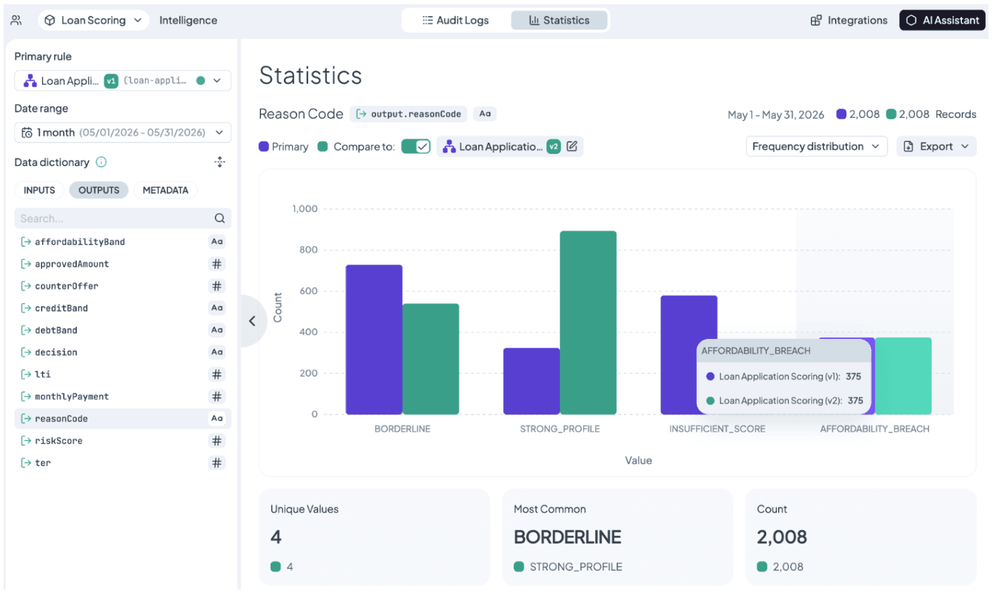
Das Ergebnis: Insufficient Score sank, Affordability Breach blieb vollständig unverändert.
decision zeigt, was geschehen ist. Drei Werte: approve, review, decline. Es ist die Aktion, die der Antragsteller erlebt, und die Zahl für den Volumenbericht.
reasonCode zeigt, welche Zeile ausgelöst wurde. Das ist wichtig, weil zwei Antragsteller DECLINE aus völlig unterschiedlichen Gründen erhalten können:
-
INSUFFICIENT_SCOREbedeutet, dass die Schwelle nicht erreicht wurde. Das ist eine verhandelbare fachliche Bewertung. Wird die Schwelle gesenkt, wird diese Person zum Kunden. -
AFFORDABILITY_BREACHbedeutet, dass die Person den Kredit nicht tragen kann. Das ist keine Bewertung, sondern eine Grenze. Keine Schwellenwertänderung darf diese Person zum Kunden machen.
Dasselbe Wort in der Entscheidung, aber eine gegensätzliche Bedeutung darunter.
Das Reason-Diagramm ergänzt entscheidende Informationen. BORDERLINE folgt REVIEW exakt von 729 auf 540. STRONG_PROFILE folgt APPROVE exakt von 324 auf 893. Drei der vier Gründe sagen nichts, was das Entscheidungsdiagramm nicht bereits zeigt. Der Wert liegt im vierten Grund: Er teilt DECLINE in zwei Ursachen, die nichts miteinander zu tun haben.
Diese Aufteilung ist das Ergebnis. INSUFFICIENT_SCORE fiel von 580 auf 200. AFFORDABILITY_BREACH blieb bei 375 zu 375. Nicht fast oder ungefähr. Unter beiden Richtlinien wurden dieselben 375 Personen aus demselben Grund abgelehnt, weil das Veto in Zeile eins und die Schwellenwerte in den Zeilen zwei und drei stehen.
Das Sicherheitsargument steckt in einer Zahl. Eine höhere Risikobereitschaft ist eine geschäftliche Entscheidung. Ein Kredit an jemanden, der nachweislich nicht zurückzahlen kann, ist ein Compliance-Problem. Beide Aspekte stehen deshalb in getrennten Zeilen, und die Bewegung der einen darf die andere nicht bewegen. Wäre AFFORDABILITY_BREACH zusammen mit INSUFFICIENT_SCORE gefallen, hätten Sie unbemerkt Kredite an Personen vergeben, die nicht zurückzahlen können. Das Entscheidungsdiagramm hätte in beiden Fällen gleich ausgesehen.
Die zentrale Designlektion lautet deshalb: Verhandelbares und Nichtverhandelbares gehören in getrennte Zeilen. So kann die eine Seite schnell geändert werden, ohne die andere zu gefährden. Anschließend zeigt das Reason-Diagramm, ob das gelungen ist.
Das Geld
approvedAmount ist eine Zahl. Statistics zeichnet sie deshalb über die Zeit, statt sie zu zählen.
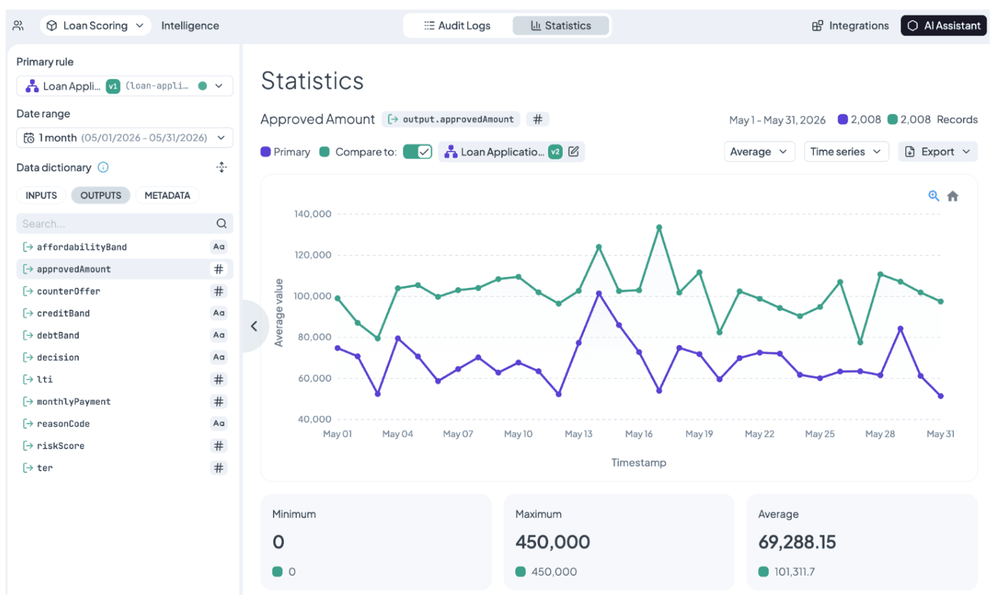
Der Durchschnitt stieg um fast die Hälfte. Unter- und Obergrenze blieben unverändert.
Vergleichen Sie das Zeitfenster dieses Diagramms mit dem früheren Diagramm, in dem Version 2 erstmals erscheint. Dort werden April und Mai gezeigt, und der Durchschnitt von Version 1 beträgt 57.432 €, gedrückt durch einen Monat, in dem Version 2 noch nicht existierte. Wird auf Mai begrenzt, sodass beide Versionen dieselben Tage abdecken, beträgt der Durchschnitt von Version 1 69.288 €.
Dieselbe Regel, dieselben Protokolle, eine andere Zahl, und keine davon ist falsch. Entscheidend ist: Der Datumsbereich ist Teil der Messung. Bei einem Vergleich muss das Zeitfenster für beide Seiten fair sein, sonst wird der Kalender statt der Änderung gemessen.
Die unveränderten Zahlen sind ebenso aussagekräftig wie die veränderte. Der Durchschnitt stieg um fast die Hälfte. Das Minimum blieb bei null, sodass beide Versionen die schlechtesten Antragsteller weiterhin direkt ablehnen. Das Maximum blieb bei 450.000 €, sodass keine Version einen höheren Kredit gewährt als beantragt.
Die Bank hat weder ihre Obergrenze erhöht noch ihre Untergrenze gesenkt. Sie hat die Mitte verschoben. Das ist der Fingerabdruck einer Schwellenwertänderung. Hätte sich stattdessen das Maximum geändert, wäre Pricing und nicht die Richtlinie bearbeitet worden.
Eine weitere Einstellung desselben Diagramms wechselt die Kennzahl vom Durchschnitt zur Summe. Durchschnittswerte beschreiben den Antragsteller, Summen das Portfolio. Dasselbe Feld und dieselben Protokolle dienen zwei verschiedenen Meetings. Der Kreditsachbearbeiter benötigt den Durchschnitt, der CFO die Summe.
Dass beide Linien Tag für Tag parallel verlaufen, statt sich wiederholt zu kreuzen, ist selbst ein Ergebnis. Eine systematische Lücke weist auf eine systematische Ursache hin. Wenige zufällig günstige Anträge würden wie Rauschen aussehen.
Der vollständige Datensatz, nicht nur ein Feld
Jedes bisherige Diagramm beantwortet eine Frage zu einem Feld. Irgendwann misstraut jemand dem Aggregat und möchte einen einzelnen Fall sehen.
Die Raw Data Table ist nicht an ein Feld gebunden. Sie zeigt die Datensätze.
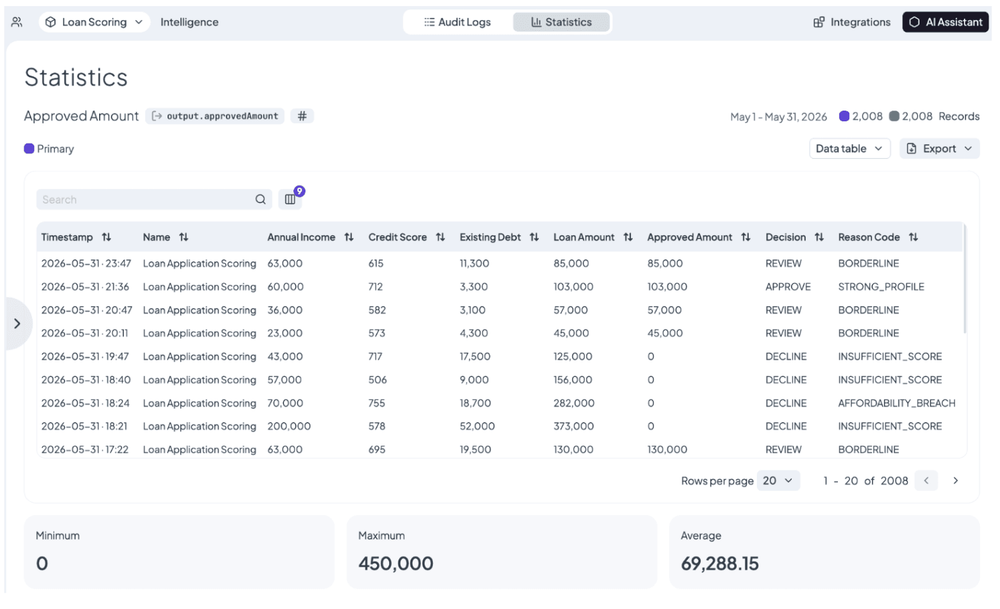
Eine Zeile pro Entscheidung. Die Diagramme sind das Argument, diese Tabelle ist der Nachweis.
Hier erweisen sich die Regler oben auf der Demo-Seite und die gesamte Population in den Diagrammen als dieselbe Sache. Der umgeschlagene Antrag lässt sich finden. Sichtbar werden das eingegangene Einkommen, der erzielte Score, die passende Zeile und der zurückgegebene Betrag.
Die Diagramme sind das Argument, die Tabelle ist der Nachweis. Die meisten Diskussionen über Richtlinienänderungen enden, sobald ein realer Datensatz auf dem Bildschirm steht.
Daten mitnehmen
Es gibt zwei Wege, je nachdem, ob die Zahl einmal oder dauerhaft benötigt wird.
Einmal: Jede Ansicht kann als CSV exportiert werden. Der Download enthält eine Metadatendatei mit einer genauen Beschreibung des Exports. Das wirkt wie Verwaltung, bis sechs Monate später eine Zahl in einer Vorstandsvorlage infrage gestellt wird und ihre Herkunft erklärt werden muss.
Dauerhaft: Die BI API stellt dieselben Audit-Logs bereit, die auch Statistics liest, gefiltert nach Regel, Version und Datum. Darauf basiert außerdem ein eigener Power BI Connector. Ihr BI-Werkzeug fragt die Entscheidungen selbst ab und nicht eine Tabelle, die jemand im März exportiert und im April nicht mehr aktualisiert hat.
Der Kreislauf schließt sich
Die Ereignisse lassen sich der Reihe nach betrachten.
Jemand hatte eine Meinung zur Genehmigungsschwelle. Die Protokolle existierten bereits, weil jede Ausführung auditiert wurde. Die Richtlinie bestand aus vier Tabellenzeilen. Eine Bearbeitung erzeugte deshalb eine neue Version, statt die alte zu zerstören. Beide Versionen liefen für dieselben Anträge. Die alte bediente weiterhin production, während die neue protokollierte, was sie entschieden hätte. Jeder Flow band eine Version fest, sodass das Experiment genau eine Variable hatte. Statistics las die Protokolle und zeichnete den Unterschied. Zahlen statt Hierarchie entschieden die Diskussion, ohne einen Kredit zu riskieren.
Danach ging Version 2 live und begann selbstständig zu protokollieren. Für die nächste Frage liegen die Nachweise bereits bereit.
Das bedeutet Decision Intelligence hier: kein nachträglich an eine Rules Engine montiertes Dashboard, sondern die bereits getroffenen Entscheidungen in einer Form, die betrachtet, hinterfragt und verbessert werden kann. Auditieren, analysieren, verbessern und erneut beginnen.
Die Demo auf der Decision Intelligence-Seite zeigt diese Regel in Ausführung. Die Regler können erneut bewegt werden, um ihre Wirkung zu sehen.